Как настроить Schema.org и Entity Graph, чтобы ChatGPT не путал ваш бренд с конкурентами
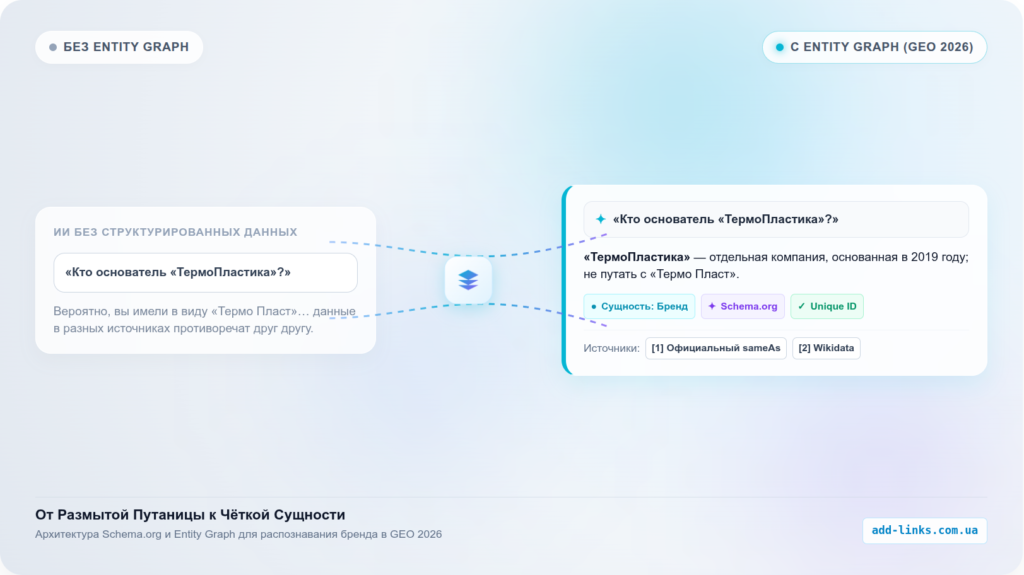
Если ChatGPT, Perplexity или Google AI Overviews путают ваш бренд с конкурентом или вообще не знают, кто вы, — причина в том, что для нейросети вы не «сущность» (Entity), а размытый фрагмент текста. Расширенная разметка Schema.org и собственный Entity Graph — связь компании, основателей, услуг и внешних источников через единые идентификаторы @id — дают модели чёткую, машиночитаемую структуру, которая устраняет эту путаницу.
Сегодня пользователи всё чаще не гуглят, а спрашивают ChatGPT, Claude или Perplexity так, будто общаются с живым консультантом: «Посоветуй надёжное агентство, которое делает линкбилдинг в Украине» или «Кто сейчас лидер на рынке оптимизации видимости бренда?».
Для нейросети ваш бренд — это не набор ключевых слов на странице, а сущность (Entity) в многомерном пространстве векторных вложений (embeddings). Если вы не объяснили алгоритмам RAG (Retrieval-Augmented Generation), кто вы, с какими продуктами ассоциируетесь и чем отличаетесь от компаний со схожим названием — модель легко «сгаллюцинирует», смешав вас с прямым конкурентом или вообще с общим термином.
Чтобы потенциальные клиенты видели в ответах ИИ именно вас, традиционных SEO-тегов title и h1 уже недостаточно. Нужна чёткая, машиночитаемая архитектура: Schema.org и собственный Entity Graph.
Анатомия путаницы: почему LLM не узнают ваш бренд
Путаница возникает не случайно — она заложена в самой механике того, как LLM обрабатывают текст.
Размытие векторного контекста (Semantic Overlap). Когда название бренда состоит из общеупотребимых слов или созвучно с названием более крупного игрока на рынке — например, вымышленные «Термо Пласт» и «ТермоПластика», или бренд вроде «Быстрая Логистика», чьё название — просто общий термин — векторная модель помещает эти тексты в один семантический кластер. Для нейросети такие сущности становятся «близкими по смыслу», а значит — взаимозаменяемыми.
Дефицит якорей (Anchor Entities). Если бренд упоминается в интернете «между делом», без чёткой связи с конкретными основателями, адресом, лицензиями, официальным доменом или отраслевыми каталогами — у модели просто нет чёткой точки привязки.
Слепые зоны RAG. Когда пользователь формулирует запрос, Perplexity или ChatGPT ищут релевантные фрагменты в базах данных или через веб-поиск. Если у конкурента эти фрагменты структурированы через Wikidata или развёрнутую Schema.org-разметку, а ваш сайт — это просто «голый» текст, ИИ выберет источник, более авторитетный для машины.
Чтобы преодолеть этот разрыв контекста, недостаточно просто писать хорошие статьи. Машине нужна жёсткая логическая структура, которая прямо говорит: «Вот бренд А, его владельцы такие-то, официальный сайт такой-то, а вот совсем другая компания Б». Именно это и даёт связка Schema.org + Entity Graph.
Базовый уровень: правильная Schema.org для идентификации бренда
Первый барьер против нейросетевых галлюцинаций — структурированная микроразметка Schema.org на главной странице и страницах услуг.
Чтобы LLM не путала ваш бренд, стандартного набора LocalBusiness или Organization недостаточно. Нужен расширенный набор свойств, который фиксирует уникальность компании:
sameAs — прямые ссылки на официальные профили в Викиданных, Crunchbase, профильных бизнес-каталогах и соцсетях. Это главный языковой якорь для модели.
knowsAbout — чёткий перечень тем, экспертизы и услуг, по которым модель должна ассоциировать ваш бренд.
founder (а при необходимости — и employee для других ключевых специалистов команды) — связь компании с реальными людьми, чьи профили также индексируются сетью.
Ниже — пример расширенного JSON-LD блока. Значения sameAs, logo и Wikidata ID здесь условные — перед публикацией замените их на реальные:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://vash-sayt.com/#organization",
      "name": "Название Бренда",
      "url": "https://vash-sayt.com/",
      "logo": "https://vash-sayt.com/wp-content/uploads/logo.png",
      "sameAs": [
        "https://www.wikidata.org/wiki/Qxxxxxxx",
        "https://www.linkedin.com/company/vash-brand",
        "https://www.crunchbase.com/organization/vash-brand"
      ],
      "knowsAbout": [
        "GEO Optimization",
        "LLM Visibility",
        "Link Building",
        "SEO"
      ],
      "founder": {
        "@type": "Person",
        "name": "Имя Фамилия"
      }
    }
  ]
}
Продвинутый уровень: построение собственного Entity Graph
Когда базовая Schema.org готова, следующий шаг — связать сущности в единую экосистему. Это превращает разрозненные страницы сайта в связный граф знаний, который поисковики и нейросети читают как один авторитетный узел информации.
sameAsПрактический кейс: как мы решили проблему слияния брендов
Один из наших проектов в нише B2B-услуг столкнулся с тем, что ChatGPT и Perplexity постоянно приписывали его кейсы другой компании со схожим названием и аналогичной деятельностью.
Что сделали: перестроили структуру страниц через связанные схемы (itemProp и вложенные Organization / Service / Person); добавили сущности основателей и экспертов в структуру сайта, связав их через author с каждой экспертной статьёй — причём каждая сущность определена один раз и переиспользуется через @id, а не дублируется на каждой странице отдельно; актуализировали внешние точки привязки (sameAs), связав их с профильными реестрами и авторитетными площадками.
Результат: через 6 недель после переиндексации нейросети перестали путать компании. Запрос в Perplexity на сравнение услуг теперь чётко выделяет клиента как отдельную независимую сущность, а доля присутствия бренда в ответах (Share of Model) выросла с 9% до 34%.
Внешние источники: подпитываем RAG-системы извне
Нейросети не доверяют информации, которая существует только в вашей внутренней среде. Алгоритмы RAG формируют ответы, опираясь на консенсус авторитетных источников. Если ваш Entity Graph идеально настроен на сайте, но о вас молчат внешние базы данных, LLM будет колебаться.
Чтобы закрепить сущность бренда в массиве данных, нужен внешний «цифровой след».
Глобальные базы знаний. Wikidata, Wikipedia (если бренд соответствует критериям значимости) и Crunchbase. Это первичные источники истины для большинства LLM.
Локальные бизнес-каталоги. Профили на авторитетных национальных платформах. Например, для украинского рынка весомыми точками привязки являются страницы на UB.UA, DOU (для IT/Tech), профильные рейтинги и реестры.
Согласованность данных NAP (Name, Address, Phone). Название компании, адрес и контакты во внешних источниках должны дословно совпадать с теми, что указаны в вашем внутреннем графе и свойствах sameAs.
Базовая микроразметка vs Собственный Entity Graph
| Критерий | Базовая Schema.org | Полноценный Entity Graph |
|---|---|---|
| Восприятие нейросетью | Отдельная страница с контактами бизнеса | Единая экосистема: бренд, услуги и эксперты |
| Использование @id | Редко. Данные дублируются на каждой странице | Постоянно. Все сущности связаны едиными идентификаторами |
| Уровень вложенности | Плоский (1–2 уровня) | Глубокий (Организация → Услуга → Эксперт → Отзыв) |
| Связь с внешним миром | Обычно отсутствует | Активное использование sameAs и knowsAbout |
| Защита от галлюцинаций LLM | Низкая (модель легко путает названия) | Высокая (чёткая идентификация бренда) |
Чек-лист и проверка результата
Чтобы проверить, готова ли ваша инфраструктура к требованиям GEO, выполните эти 5 шагов:
- Проведите аудит текущих сущностей. Проверьте главную страницу через validator.schema.org (корректность синтаксиса) и Google Rich Results Test (будут ли данные учтены для расширенных сниппетов). Убедитесь, что там есть тип
Organization(или специфический бизнес). - Добавьте языковые якоря. Пропишите свойства
sameAsсо ссылками на ваши профили в соцсетях и бизнес-каталогах. - Настройте узлы через @id. Убедитесь, что страницы услуг, авторов и продуктов ссылаются на главную сущность компании, а не существуют изолированно.
- Определите экспертизу. Используйте
knowsAbout, чтобы чётко указать технологии и ниши, в которых вы работаете. - Протестируйте результат в LLM. Через 4–6 недель после внедрения сделайте запрос в Perplexity или ChatGPT.
FAQ: часто задаваемые вопросы о внедрении Entity Graph
Сколько времени нужно нейросетям, чтобы «увидеть» новый граф?
Скорость зависит от того, есть ли у модели доступ к веб-поиску. Системы с активным RAG (например, Perplexity или современные чат-боты с браузингом) обычно показывают первые изменения через 3–4 недели после индексации страниц поисковыми системами. Модели без доступа к вебу (офлайн-режим) увидят обновлённый граф только во время следующего глобального переобучения.
Нужен ли разработчик для создания Entity Graph?
Для базовой настройки JSON-LD часто достаточно SEO-плагинов. Но для построения глубокого графа с перекрёстными ссылками через @id требуется ручное вмешательство или кастомная разработка, чтобы интегрировать код в шаблон сайта.
Сработает ли это для малого бизнеса или локального бренда?
Да. Для локального бизнеса Entity Graph работает даже эффективнее, поскольку конкуренты редко используют сложную разметку. Связка LocalBusiness с локальными реестрами быстро выделяет бренд среди общих названий.
Время закрепить ваш бренд в нейросетях
Путаница в ChatGPT — это не временный баг, а системная проблема компаний, которые продолжают оптимизировать сайты только под традиционные поисковики. Пока вы теряете трафик из-за размытого контекста, конкуренты с чёткой структурой данных перетягивают рекомендации ИИ на себя.
Команда Terrum Agency специализируется на архитектуре данных для алгоритмов нового поколения.
👉 Бесплатный GEO-аудит сайта Мы проанализируем вашу текущую семантическую структуру, проверим, как LLM видят ваш бренд сегодня, и составим пошаговый план внедрения Entity Graph.