Як налаштувати Schema.org та Entity Graph, щоб ChatGPT не плутав ваш бренд із конкурентами
Якщо ChatGPT, Perplexity чи Google AI Overviews плутають ваш бренд із конкурентом або взагалі не знають, хто ви, — причина в тому, що для нейромережі ви не «сутність» (Entity), а розмитий фрагмент тексту. Розширена розмітка Schema.org та власний Entity Graph — зв’язок компанії, засновників, послуг і зовнішніх джерел через єдині ідентифікатори @id — дають моделі чітку, машиночитану структуру, яка усуває цю плутанину.
Сьогодні користувачі дедалі частіше не гуглять, а запитують ChatGPT, Claude чи Perplexity так, ніби спілкуються з живим консультантом: «Порадь надійне агентство, яке робить лінкбілдинг в Україні» або «Хто зараз лідер на ринку оптимізації видимості бренду?».
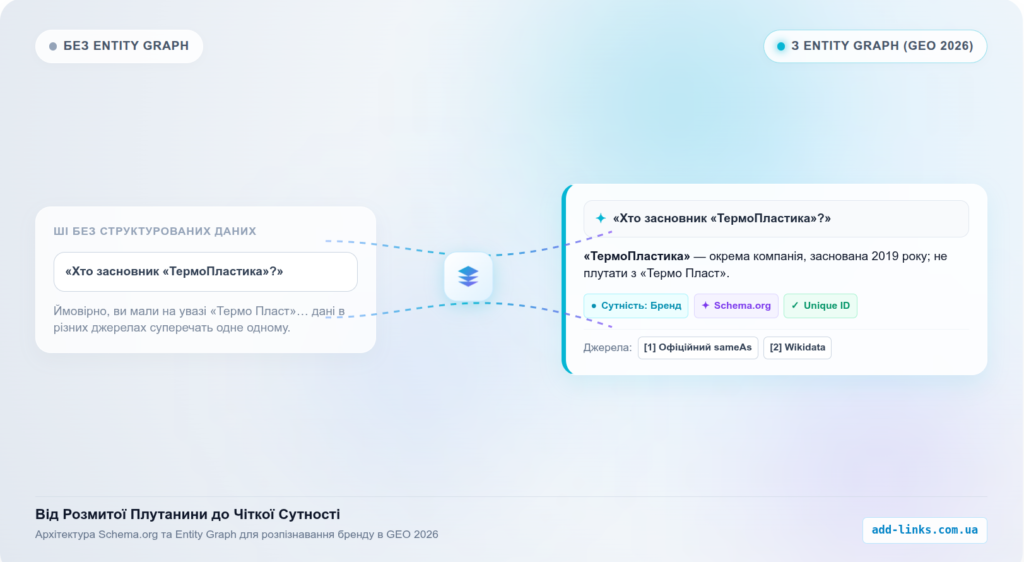
Для нейромережі ваш бренд — це не набір ключових слів на сторінці, а сутність (Entity) у багатовимірному просторі векторних вбудовувань (embeddings). Якщо ви не пояснили алгоритмам RAG (Retrieval-Augmented Generation), хто ви, з якими продуктами асоціюєтесь і чим відрізняєтесь від компаній зі схожою назвою — модель легко «згалюцинує», змішавши вас із прямим конкурентом або взагалі із загальним терміном.
Щоб потенційні клієнти бачили у відповідях ШІ саме вас, традиційних SEO-тегів title та h1 уже недостатньо. Потрібна чітка, машиночитана архітектура: Schema.org і власний Entity Graph.
Анатомія плутанини: чому LLM не впізнають ваш бренд
Плутанина виникає не випадково — вона закладена в самій механіці того, як LLM обробляють текст.
Розмиття векторного контексту (Semantic Overlap). Коли назва бренду складається із загальновживаних слів або співзвучна з назвою більшого гравця на ринку — наприклад, вигадані «Термо Пласт» і «ТермоПластика», або бренд на кшталт «Швидка Логістика», чия назва — просто загальний термін — векторна модель поміщає ці тексти в один семантичний кластер. Для нейромережі такі сутності стають «близькими за змістом», а отже, взаємозамінними.
Дефіцит якорів (Anchor Entities). Якщо бренд згадується в інтернеті «між іншим», без чіткого зв’язку з конкретними засновниками, адресою, ліцензіями, офіційним доменом чи галузевими каталогами — у моделі просто немає чіткої точки прив’язки.
Сліпі зони RAG. Коли користувач формулює запит, Perplexity чи ChatGPT шукають релевантні фрагменти в базах даних або через вебпошук. Якщо в конкурента ці фрагменти структуровані через Wikidata чи розгорнуту Schema.org-розмітку, а ваш сайт — це просто «голий» текст, ШІ обере джерело, авторитетніше для машини.
Щоб подолати цей розрив контексту, недостатньо просто писати гарні статті. Машині потрібна жорстка логічна структура, яка прямо каже: «Ось бренд А, його власники такі-то, офіційний сайт такий-то, а ось зовсім інша компанія Б». Саме це і дає зв’язка Schema.org + Entity Graph.
Базовий рівень: правильна Schema.org для ідентифікації бренду
Перший бар’єр проти нейромережевих галюцинацій — структурована мікророзмітка Schema.org на головній сторінці та сторінках послуг.
Щоб LLM не плутала ваш бренд, стандартного набору LocalBusiness чи Organization недостатньо. Потрібен розширений набір властивостей, який фіксує унікальність компанії:
sameAs — прямі посилання на офіційні профілі у Вікіданих, Crunchbase, профільних бізнес-каталогах та соцмережах. Це головний мовний якір для моделі.
knowsAbout — чіткий перелік тем, експертизи та послуг, за якими модель має асоціювати ваш бренд.
founder (а за потреби — і employee для інших ключових фахівців команди) — зв’язок компанії з реальними людьми, чиї профілі також індексуються мережею.
Нижче — приклад розширеного JSON-LD блоку. Значення sameAs, logo та Wikidata ID тут умовні — перед публікацією замініть їх на реальні:
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://vash-sayt.com/#organization",
      "name": "Назва Бренду",
      "url": "https://vash-sayt.com/",
      "logo": "https://vash-sayt.com/wp-content/uploads/logo.png",
      "sameAs": [
        "https://www.wikidata.org/wiki/Qxxxxxxx",
        "https://www.linkedin.com/company/vash-brand",
        "https://www.crunchbase.com/organization/vash-brand"
      ],
      "knowsAbout": [
        "GEO Optimization",
        "LLM Visibility",
        "Link Building",
        "SEO"
      ],
      "founder": {
        "@type": "Person",
        "name": "Ім'я Прізвище"
      }
    }
  ]
}
Просунутий рівень: побудова власного Entity Graph
Коли базова Schema.org готова, наступний крок — зв’язати сутності в єдину екосистему. Це перетворює розрізнені сторінки сайту на зв’язний граф знань, який пошуковики й нейромережі читають як один авторитетний вузол інформації.
sameAsПрактичний кейс: як ми розв’язали проблему злиття брендів
Один із наших проєктів у ніші B2B-послуг зіткнувся з тим, що ChatGPT та Perplexity постійно приписували його кейси іншій компанії зі схожою назвою та аналогічною діяльністю.
Що зробили: перебудували структуру сторінок через зв’язані схеми (itemProp та вкладені Organization / Service / Person); додали сутності засновників та експертів у структуру сайту, зв’язавши їх через author з кожною експертною статтею — причому кожна сутність визначена один раз і переговорена через @id, а не дублюється на кожній сторінці окремо; актуалізували зовнішні точки прив’язки (sameAs), пов’язавши їх із профільними реєстрами та авторитетними майданчиками.
Результат: через 6 тижнів після переіндексації нейромережі перестали плутати компанії. Запит у Perplexity на порівняння послуг тепер чітко виділяє клієнта як окрему незалежну сутність, а частка присутності бренду у відповідях (Share of Model) зросла з 9% до 34%.
Зовнішні джерела: підживлюємо RAG-системи ззовні
Нейромережі не довіряють інформації, яка існує лише у вашому внутрішньому середовищі. Алгоритми RAG формують відповіді, спираючись на консенсус авторитетних джерел. Якщо ваш Entity Graph ідеально налаштований на сайті, але про вас мовчать зовнішні бази даних, LLM вагатиметься.
Щоб закріпити сутність бренду в масиві даних, потрібен зовнішній «цифровий слід».
Глобальні бази знань. Wikidata, Wikipedia (якщо бренд відповідає критеріям значущості) та Crunchbase. Це первинні джерела правди для більшості LLM.
Локальні бізнес-каталоги. Профілі на авторитетних національних платформах. Наприклад, для українського ринку вагомими точками прив’язки є сторінки на UB.UA, DOU (для IT/Tech), профільні рейтинги та реєстри.
Узгодженість даних NAP (Name, Address, Phone). Назва компанії, адреса та контакти у зовнішніх джерелах повинні дослівно збігатися з тими, що вказані у вашому внутрішньому графі та властивостях sameAs.
Базова мікророзмітка vs Власний Entity Graph
| Критерій | Базова Schema.org | Повноцінний Entity Graph |
|---|---|---|
| Сприйняття нейромережею | Окрема сторінка з контактами бізнесу | Єдина екосистема: бренд, послуги та експерти |
| Використання @id | Рідко. Дані дублюються на кожній сторінці | Постійно. Всі сутності пов’язані єдиними ідентифікаторами |
| Рівень вкладеності | Плоский (1–2 рівні) | Глибокий (Організація → Послуга → Експерт → Відгук) |
| Зв’язок із зовнішнім світом | Зазвичай відсутній | Активне використання sameAs та knowsAbout |
| Захист від галюцинацій LLM | Низький (модель легко плутає назви) | Високий (чітка ідентифікація бренду) |
Чек-лист та перевірка результату
Щоб перевірити, чи готова ваша інфраструктура до вимог GEO, виконайте ці 5 кроків:
- Проведіть аудит поточних сутностей. Перевірте головну сторінку через validator.schema.org (коректність синтаксису) та Google Rich Results Test (чи будуть дані враховані для розширених сніпетів). Переконайтеся, що там є тип
Organization(або специфічний бізнес). - Додайте мовні якорі. Пропишіть властивості
sameAsіз посиланнями на ваші профілі у соцмережах та бізнес-каталогах. - Налаштуйте вузли через @id. Переконайтеся, що сторінки послуг, авторів та продуктів посилаються на головну сутність компанії, а не існують ізольовано.
- Визначте експертизу. Використайте
knowsAbout, щоб чітко вказати технології та ніші, у яких ви працюєте. - Протестуйте результат у LLM. Через 4–6 тижнів після впровадження зробіть запит у Perplexity або ChatGPT.
FAQ: часті запитання про впровадження Entity Graph
Скільки часу потрібно нейромережам, щоб «побачити» новий граф?
Швидкість залежить від того, чи має модель доступ до вебпошуку. Системи з активним RAG (наприклад, Perplexity чи сучасні чат-боти з браузингом) зазвичай показують перші зміни через 3–4 тижні після індексації сторінок пошуковими системами. Моделі без доступу до вебу (офлайн-режим) побачать оновлений граф лише під час наступного глобального перенавчання.
Чи потрібен розробник для створення Entity Graph?
Для базового налаштування JSON-LD часто достатньо SEO-плагінів. Але для побудови глибокого графа із перехресними посиланнями через @id потрібне ручне втручання або кастомна розробка, щоб інтегрувати код у шаблон сайту.
Чи спрацює це для малого бізнесу або локального бренду?
Так. Для локального бізнесу Entity Graph працює навіть ефективніше, оскільки конкуренти рідко використовують складну розмітку. Зв’язка LocalBusiness з локальними реєстрами швидко виділяє бренд серед загальних назв.
Час закріпити ваш бренд у нейромережах
Плутанина в ChatGPT — це не тимчасовий баг, а системна проблема компаній, які продовжують оптимізувати сайти лише під традиційні пошуковики. Поки ви втрачаєте трафік через розмитий контекст, конкуренти із чіткою структурою даних перетягують рекомендації ШІ на себе.
Команда Terrum Agency спеціалізується на архітектурі даних для алгоритмів нового покоління.
👉 Безкоштовний GEO-аудит сайту Ми проаналізуємо вашу поточну семантичну структуру, перевіримо, як LLM бачать ваш бренд сьогодні, і складемо покроковий план впровадження Entity Graph.